CloudflareでAIをブロックするとどうなる?AI Bot対策のメリットとデメリット
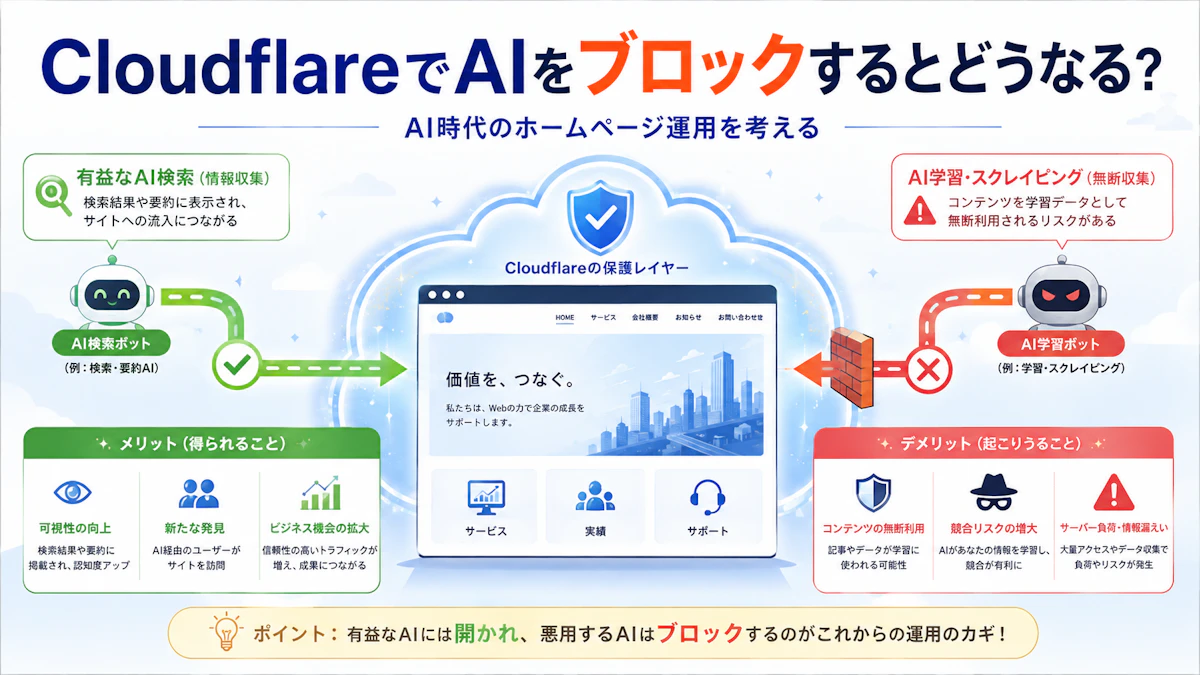
「CloudflareにするとAIが見に来られなくなる」は本当?
最近
「Cloudflareを使うとAIやBotがブロックされる」
という話を目にすることがあります。
確かにCloudflareには、AIクローラーを制御する機能があります。
ただ
Cloudflareを使っただけで、すべてのAIが一律に見られなくなる
という理解は少し違います。
現在のCloudflareでは、AIによるアクセスを目的別に分けて管理できます。
大きく分けると
- AI Search
- AI Agent
- AI Training
の3種類です。
この違いを理解すると
「全部許可する」
「全部止める」
以外の選択肢が見えてきます。
そもそもBotとは?
Botとは、人間がブラウザーを操作する代わりに、自動でWebサイトへアクセスするプログラムです。
Botという言葉には悪い印象がありますが、すべてが悪者ではありません。
Google検索のためにサイトを巡回するGooglebotもBotです。
一方で
- パスワードを大量に試す
- 商品を買い占める
- コンテンツを大量取得する
といった迷惑なBotもあります。
最近はさらに、AIがWebサイトを利用するためのBotが増えてきました。
Cloudflareでは、それらをまとめて「AI Bot」とせず、何のためにアクセスするのかで分類しています。
AI Searchは「あとで検索結果に使う」ためのアクセス
AI Searchは、Webサイトの内容を収集・索引化し、あとからAIが質問へ回答するときに利用するためのアクセスです。
例えば利用者がAIへ
「この会社はどんなサービスを提供していますか?」
と質問したとき、自社サイトの内容が検索対象として参照されるイメージです。
この種類までブロックすると
AI検索から自社サイトを見つけてもらう機会を減らす可能性があります。
これからAI検索が一般化していくことを考えると、企業サイトでは無条件に止める前に一度考えたいところです。
AI Agentは「今、このページを見て」と頼まれたときのアクセス
AI Agentは、利用者の依頼を受け、リアルタイムでWebサイトへアクセスする仕組みです。
例えば
「この会社の料金ページを確認して」
「このページを読んで内容をまとめて」
とAIへ頼んだ場合です。
AIが人の代わりにWebページへアクセスします。
ここをブロックすると、AIがその場で自社サイトを確認できないことがあります。
企業サイトとして
AI経由でも情報を取得してほしいのか
によって判断が変わります。
AI Trainingは「AIモデルを学習させる」ためのアクセス
3つ目がAI Trainingです。
これはWebサイトの内容を取得し、AIモデルの学習や追加学習などへ利用する目的のアクセスです。
自社独自の記事。
写真。
ノウハウ。
有料で制作したコンテンツ。
こうした情報を
AIの学習材料として自由に使ってほしくない
と考える会社もあると思います。
その場合、Trainingをブロックする意味があります。
CloudflareのAI Crawl Controlでは、こうしたAIクローラーのアクセス状況を確認しながら、個別に許可・拒否できます。
「AIをブロックする」メリット
AI関連Botを適切に制御することで
- 学習目的のコンテンツ取得を制限できる
- 不要なクロールを減らせる
- どのAIサービスがアクセスしているか確認できる
- AIサービスごとに許可・拒否を決められる
- robots.txtだけではなく実際のアクセス制御もできる
といったメリットがあります。
特に
「自社で時間をかけて作った記事を、AI学習へ無条件に利用してほしくない」
という場合には、有効な選択肢です。
でも「全部ブロック」にはデメリットもある
ここが今回の記事で一番お伝えしたい部分です。
AIからコンテンツを守ることだけを考えると
「全部止めればいい」
と思うかもしれません。
しかし、その結果
AIから会社を見つけてもらう機会まで減らす
可能性があります。
今後
Google検索だけでなく、ChatGPTやClaude、Perplexityなどへ直接
「○○地域でホームページ制作をしている会社を探して」
と聞く人が増えるかもしれません。
そのとき、AI Searchまで拒否していると、自社サイトが参照されにくくなる可能性があります。
つまり
AIから守ることと、AIから見つけてもらうことには、場合によってトレードオフになりえます。
Google検索まで止まるわけではありません
ここも誤解されやすいところです。
Cloudflareでは、Googlebotのような通常の検索エンジンクローラーと、AI SearchやAI Training用のBotは別に分類されています。
そのため
AI Botを制御したからといって、Google検索そのものが自動的に止まるわけではありません。
ただし、自分でWAFやBot対策のルールを厳しく設定した場合は別です。
正常な検索エンジンまで誤って止めてしまう可能性があります。
セキュリティ対策は、強くすればするほど良いわけではありません。
必要な通信まで遮断していないか確認することが大切です。
2026年9月からCloudflareの初期設定も変わります
Cloudflareは、2026年9月15日から新規ドメイン向けのAI Bot設定を変更する予定です。
現時点で案内されている新しい既定設定では、広告を表示するページについて
AI Search:許可
AI Agent:ブロック
AI Training:ブロック
という方向になります。
つまりCloudflare自身も
AIアクセスを全部同じ扱いにはしない
方向へ進んでいます。
AI検索には見つけてもらう。
一方、学習目的などは制限する。
Webサイト側が用途を見ながら選ぶ時代になってきています。
TrusKiteなら、企業サイトではどう考えるか
例えば一般的な企業ホームページなら、私は最初からすべてを遮断する必要はないと考えます。
一例として
AI Search
基本的には許可を検討
会社やサービスをAI検索から見つけてもらうためです。
AI Training
必要に応じてブロック
独自記事や制作物を学習目的に利用されたくない場合は制限します。
AI Agent
サイトの用途を見ながら判断
AIが利用者の代わりにサイトを確認することを許可するかどうかを決めます。
もちろん、これがすべての会社に当てはまるわけではありません。
メディアサイト。
会員向けサイト。
ECサイト。
企業サイト。
それぞれ守りたいものと、見つけてもらいたい情報が違います。
Cloudflareは「AIを止めるサービス」ではありません
Cloudflareを利用すると、Botを強く遮断できる。
これは事実です。
ただし、それだけが目的ではありません。
AI Crawl Controlでは
どのAIサービスがアクセスしているのか確認し、そのうえで許可・拒否を選べる
ようになっています。
大切なのは
「AIだからブロックする」ではなく「そのAIは何をしに来ているのか」を見ること
です。
検索してほしい。
学習には使ってほしくない。
利用者の依頼ならアクセスしてもよい。
そういった細かな判断ができることが、Cloudflareを利用するメリットの一つだと思います。
ホームページも「AIからどう見られるか」を考える時代へ
これまでホームページ制作では
「Googleにどう見つけてもらうか」
を考えることが中心でした。
これからは、それに加えて
AIからどう見つけてもらうか。
AIにどこまで利用を許可するか。
という考え方も必要になってくるかもしれません。
全部公開する。
全部拒否する。
その二択ではありません。
Cloudflareには、その間を選べる仕組みがあります。
TrusKiteでも今後Cloudflareを利用したホームページ制作を進める際には、表示速度やセキュリティだけでなく
検索エンジンとAI Botの両方を含め、公開後に誰へ情報を届けたいのか
まで考えて設定していきたいと思います。
便利な機能だからオンにする。
怖いから全部ブロックする。
その前に
「何を守り、誰には届けたいのか」
を一度考えてみる。
AI時代のホームページ運用では、そんな判断がこれまで以上に大切になりそうです。
TrusKiteでは、あなたのホームページに適した運用をご提案可能です。
※Bot:Webサイトへ自動的にアクセスし、特定の処理を行うプログラムです。
※AI Search:AIが後から回答に利用するため、Webコンテンツを検索・索引化する目的のアクセスです。
※AI Agent:利用者の依頼を受け、リアルタイムでWebサイトへアクセスする自動処理です。
※AI Training:AIモデルの学習・追加学習を目的としてWebコンテンツを取得するアクセスです。
※WAF:Web Application Firewallの略で、Webサイトへの通信をルールに基づいて検査・遮断する仕組みです。
※robots.txt:検索エンジンやBotへ、サイト内のクロール方針を伝えるためのファイルです。
※本記事は2026年8月時点のCloudflare公式情報をもとに作成しています。